ConvNetwork
Un réseau de neurones convolutif écrit intégralement à la main en C++, entraîné sur MNIST jusqu'à 97,4 % de précision — sans aucune bibliothèque de deep learning.
Implémentation manuelle d'un CNN complet en C++ — convolution, max pooling, couches denses, rétropropagation et optimiseur Adam — dans la même démarche que TransformerCpp : comprendre chaque opération en l'écrivant et en la testant soi-même plutôt qu'en s'appuyant sur une bibliothèque existante.
Le projet part d'une classe Matrix maison (allocation brute, règle des cinq, initialisation He) et construit dessus les couches d'un CNN classique : convolution 2D multi-canaux à padding « same », max pooling 2×2, couches entièrement connectées. Elles s'assemblent en blocs réutilisables (Conv2D → MaxPooling → ReLU) puis en réseau complet, terminé par un flatten, une couche dense et un softmax fusionné à la cross-entropy pour un gradient numériquement stable.
La partie la plus exigeante est la passe arrière, dérivée et codée à la main pour chaque couche : gradient de la convolution par rapport aux filtres et à l'entrée, et routage du gradient du max pooling vers la seule position qui a gagné le maximum au forward. Un optimiseur Adam maison (moments d'ordre 1 et 2, correction de biais) est branché sur les couches Conv2D et Dense. Le tout est validé par un test de sur-apprentissage volontaire : le réseau doit faire chuter la perte sur un exemple unique répété — si la rétropropagation est fausse quelque part, ce test échoue immédiatement.
Sur MNIST, l'architecture retenue reste volontairement simple — un bloc convolutif de 8 filtres 3×3, un pooling qui ramène l'image à 14×14×8, puis une couche dense vers les 10 classes — et atteint 97,4 % de précision sur le jeu de test après une seule epoch d'entraînement, avec Adam à un taux d'apprentissage de 0,001. L'ensemble tourne sur CPU, une image à la fois, à environ 1 200 exemples par seconde.
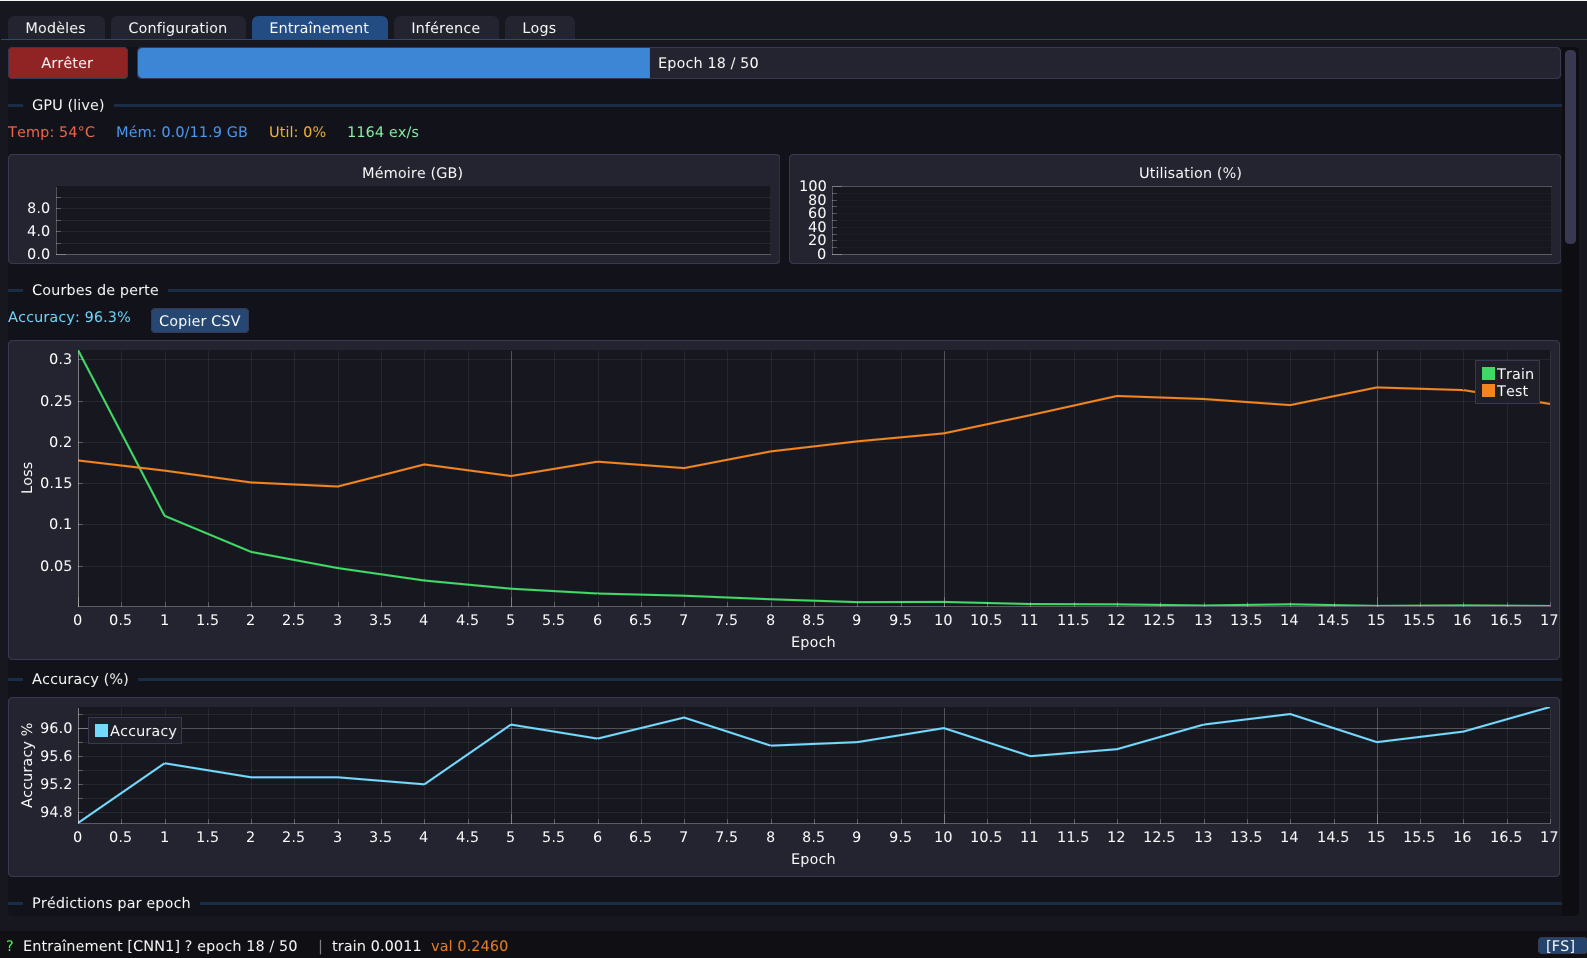
Le réseau a ensuite été branché dans TrainerApp, l'interface graphique développée pour TransformerCpp : celle-ci est devenue une petite plateforme d'entraînement multi-modèles, capable de piloter indifféremment le Transformer CUDA et ce CNN CPU via un adaptateur dédié, avec le même suivi en direct des courbes de perte et de précision.
Ce suivi rend d'ailleurs très lisible la principale limite du modèle : sur un entraînement long, la perte d'entraînement s'effondre vers 0,001 tandis que la perte de test remonte franchement à partir de la troisième epoch, et la précision plafonne autour de 96 %. C'est un cas d'école de sur-apprentissage, attendu pour un réseau sans régularisation ni augmentation de données — les leviers évidents pour aller plus loin étant le batching, le dropout, et un portage GPU dans la lignée de TransformerCpp.
Points clés
- Convolution, max pooling et couches denses codées à la main en C++, forward et backward compris
- Optimiseur Adam maison, validé par un test de sur-apprentissage sur un exemple unique
- 97,4 % de précision sur MNIST après une seule epoch, sans aucune bibliothèque de deep learning
- Intégré comme second modèle de TrainerApp, aux côtés de TransformerCpp