Segmentation 3D de défauts en tomographie industrielle
Combien de données réelles faut-il pour détecter automatiquement des défauts internes ? Une étude menée de la fabrication des pièces jusqu'au modèle entraîné.
Stage de recherche de quatre mois à l'University of Bradford (laboratoire Smart Manufacturing) : concevoir et évaluer une chaîne complète de segmentation automatique de défauts internes en tomographie à rayons X, en cherchant à contourner l'obstacle central du domaine — la rareté des volumes industriels annotés.
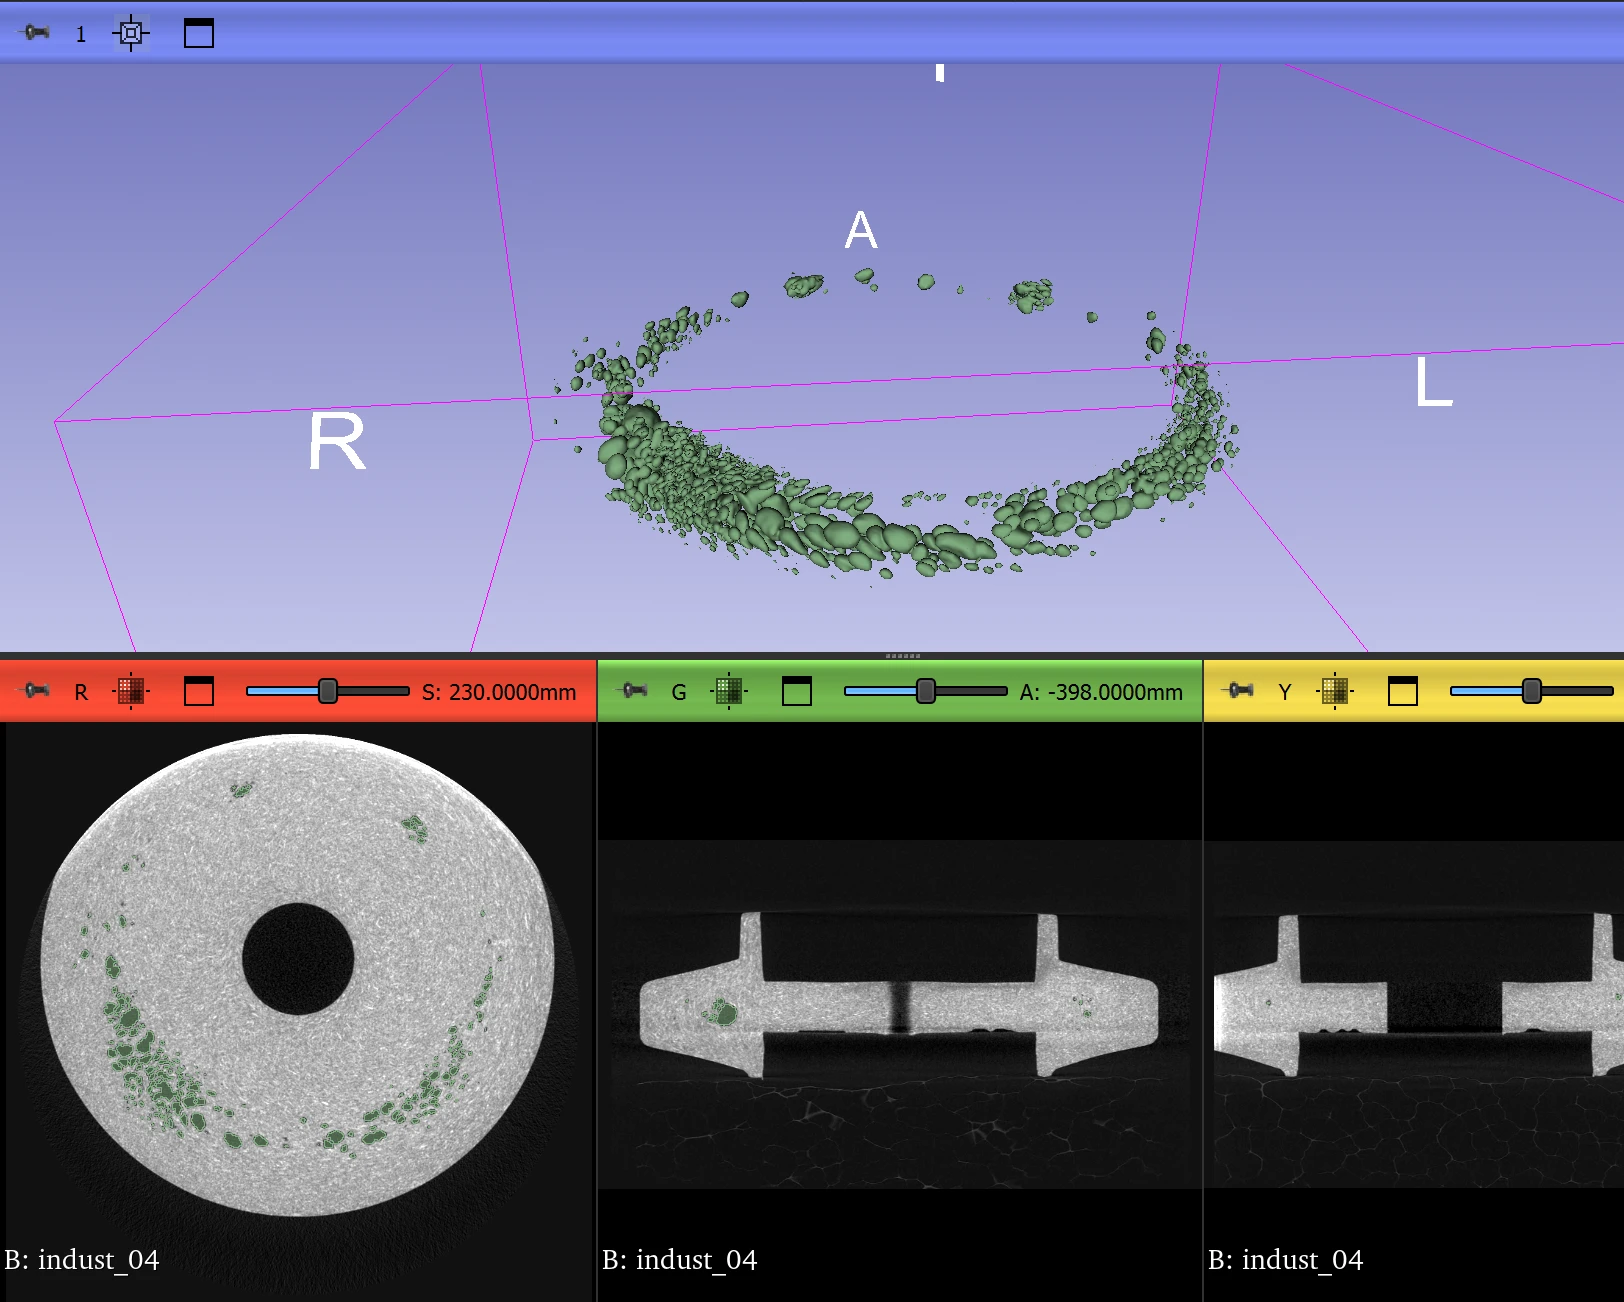
Le contrôle non destructif par tomographie permet de détecter porosités, fissures et inclusions sans abîmer la pièce, mais automatiser cette inspection par apprentissage profond se heurte à un mur : chaque scan représente plusieurs milliards de voxels, les défauts sont rares et irréguliers, et l'annotation manuelle par un expert est lente, subjective et impossible à passer à l'échelle. La question du stage était donc économique autant que scientifique : combien de données réelles faut-il réellement, et que valent les sources de substitution ?
Premier levier : fabriquer la donnée plutôt que l'annoter. J'ai écrit un générateur paramétrique de pièces de test en Python (trimesh, opérations booléennes de maillages) creusant des défauts internes délibérés — sphères, ellipsoïdes, blobs, fissures fines, amas de pores — dans des corps simples imprimés ensuite à 100 % de remplissage, puis scannés au tomographe du laboratoire. La pièce étant nominalement pleine, tout vide interne est par construction un défaut : la vérité terrain se dérive alors du scan par simple seuillage d'intensité, sans recalage CAO ni intervention manuelle.
Second levier : le transfert d'apprentissage depuis l'imagerie médicale, qui dispose de jeux publics abondants. J'ai calibré la chaîne de segmentation (architecture Swin-UNETR, PyTorch et MONAI) sur des volumes CT thoraciques publics, en portant le Dice de 0,33 à 0,53 par six améliorations méthodologiques validées séparément — entropie croisée pondérée, augmentation spatiale et d'intensité, planification du taux d'apprentissage au dégel de l'encodeur, échantillonnage équilibré des patchs, terme focal.
Le cœur de l'étude compare trois initialisations du même réseau, à protocole strictement identique : poids aléatoires, pré-entraînement auto-supervisé, et auto-supervisé complété d'un affinage médical. En ré-entraînant chacune sur des sous-ensembles emboîtés de 5 à 63 pièces avec plusieurs graines aléatoires, on obtient une courbe d'efficacité en données qui montre que le pré-entraînement accélère systématiquement la convergence, mais n'améliore la précision finale qu'au-delà d'une vingtaine de pièces — en deçà, il peut même être contre-productif.
La validation finale porte sur des pièces industrielles réelles à défauts d'usinage authentiques, scannées et corrigées à la main sous 3D Slicer, évaluées en validation croisée leave-one-out. C'est là que se joue le résultat le plus utile pour l'industrie, et il est net : quelques pièces réelles du domaine cible valent mieux qu'un volume bien supérieur de données fabriquées, aussi soigneusement construites soient-elles.
Au-delà des résultats, ce stage a été une leçon de méthode. Deux bugs découverts en cours d'étude auraient chacun pu fausser silencieusement les conclusions : un mécanisme de reprise après plantage qui avantageait mécaniquement l'initialisation aléatoire, et un chargeur de poids trop permissif qui rejetait en silence tout un point de contrôle pré-entraîné tout en affichant un message de succès. Depuis, je ne considère plus qu'un composant fonctionne parce qu'il l'affirme : comptage explicite des tenseurs chargés, échec bruyant plutôt que dégradation silencieuse.
Points clés
- Chaîne complète menée seul : conception paramétrique, impression 3D, acquisition tomographique, annotation automatique, entraînement, validation statistique
- 90 pièces annotées sans aucune annotation manuelle grâce au pipeline de génération de vérité terrain
- Comparaison contrôlée de trois stratégies d'initialisation, étayée par graines multiples et tests de Wilcoxon appariés
- Article de recherche de 13 pages rédigé en anglais, en cours d'évaluation