Un Transformer encodeur-décodeur (traduction anglais → français) écrit intégralement à la main en C++17, entraîné sur GPU via un backend CUDA maison.
Implémentation from scratch de l'architecture Transformer (« Attention Is All You Need ») pour la traduction anglais → français : toute l'algèbre, les couches, la rétropropagation, l'optimiseur Adam, le tokenizer et le backend GPU sont écrits à la main, sans bibliothèque de deep learning.
Le cœur du projet est une implémentation CPU de référence où chaque couche (attention, multi-têtes, feed-forward, layer norm, embeddings, blocs encodeur/décodeur) expose un forward et un backward dérivés et codés à la main, validés par gradient checking.
Anatomie d'un bloc : self-attention puis feed-forward, chacun suivi d'un dropout, d'une connexion résiduelle et d'une LayerNorm. Le décodeur insère en plus une attention croisée dont les clés et valeurs proviennent de la sortie de l'encodeur.
Un backend CUDA device-resident reproduit exactement les mêmes calculs mais fait vivre et entraîner le modèle entièrement sur le GPU (cuBLAS pour les produits matriciels, kernels maison pour softmax, layer norm et embedding scatter), chaque couche GPU étant validée par un test d'équivalence contre son homologue CPU. Le passage à un batching bloc-diagonal sur GPU a fait passer le débit d'entraînement d'environ 30 à 900 exemples par seconde.
Deux implémentations, une seule logique : chaque couche CPU (Matrix, boucles explicites) a son miroir GPU (GpuMatrix, cuBLAS, kernels CUDA) construit avec les mêmes poids. Un test d'équivalence compare leurs sorties couche par couche, et un format de checkpoint binaire identique rend les deux backends interchangeables.
Le projet inclut aussi un tokenizer BPE byte-level, un pipeline de données (corpus parallèle, teacher forcing, batching, padding), le checkpointing binaire des poids compatible CPU/GPU, la génération auto-régressive (glouton puis beam search), et une suite de tests exhaustive : 140 cas et environ 9000 assertions.
Le trajet complet d'un batch : le corpus est tokenisé et regroupé en batches triés par longueur côté hôte, puis seuls les identifiants de tokens partent sur le GPU. Une région capturée en CUDA Graph y enchaîne encodeur, décodeur, perte et rétropropagation sans repasser par l'hôte, avant la mise à jour Adam — le mécanisme derrière le gain de débit ×30.
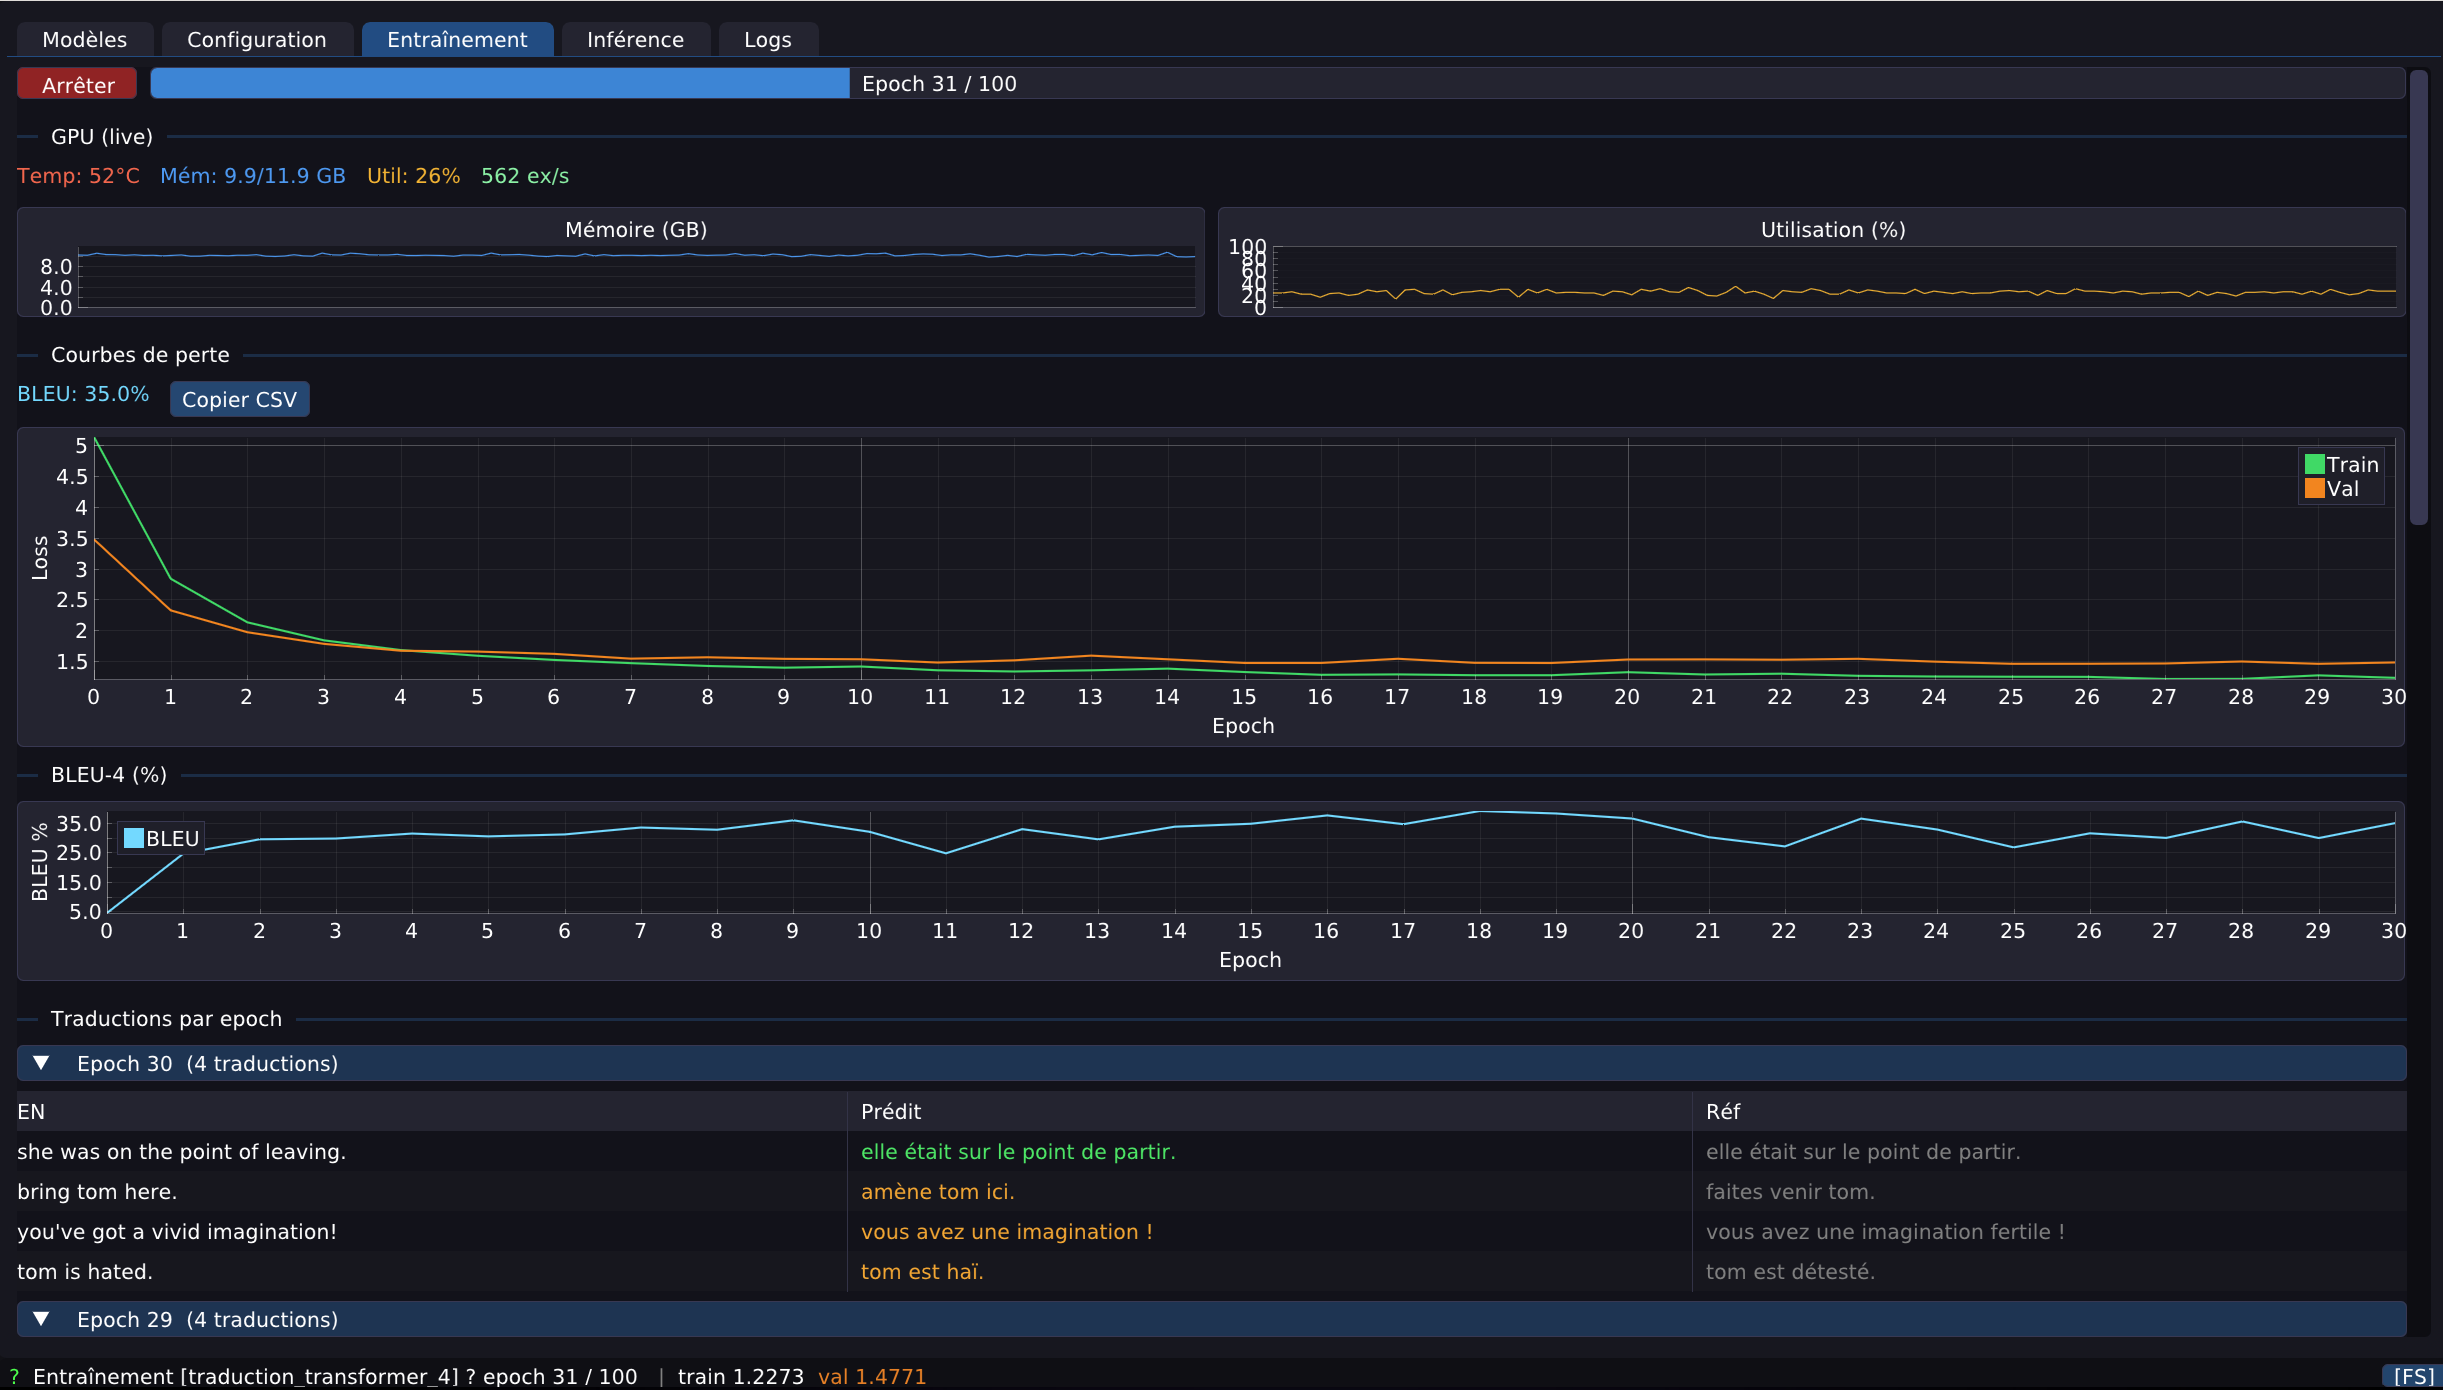
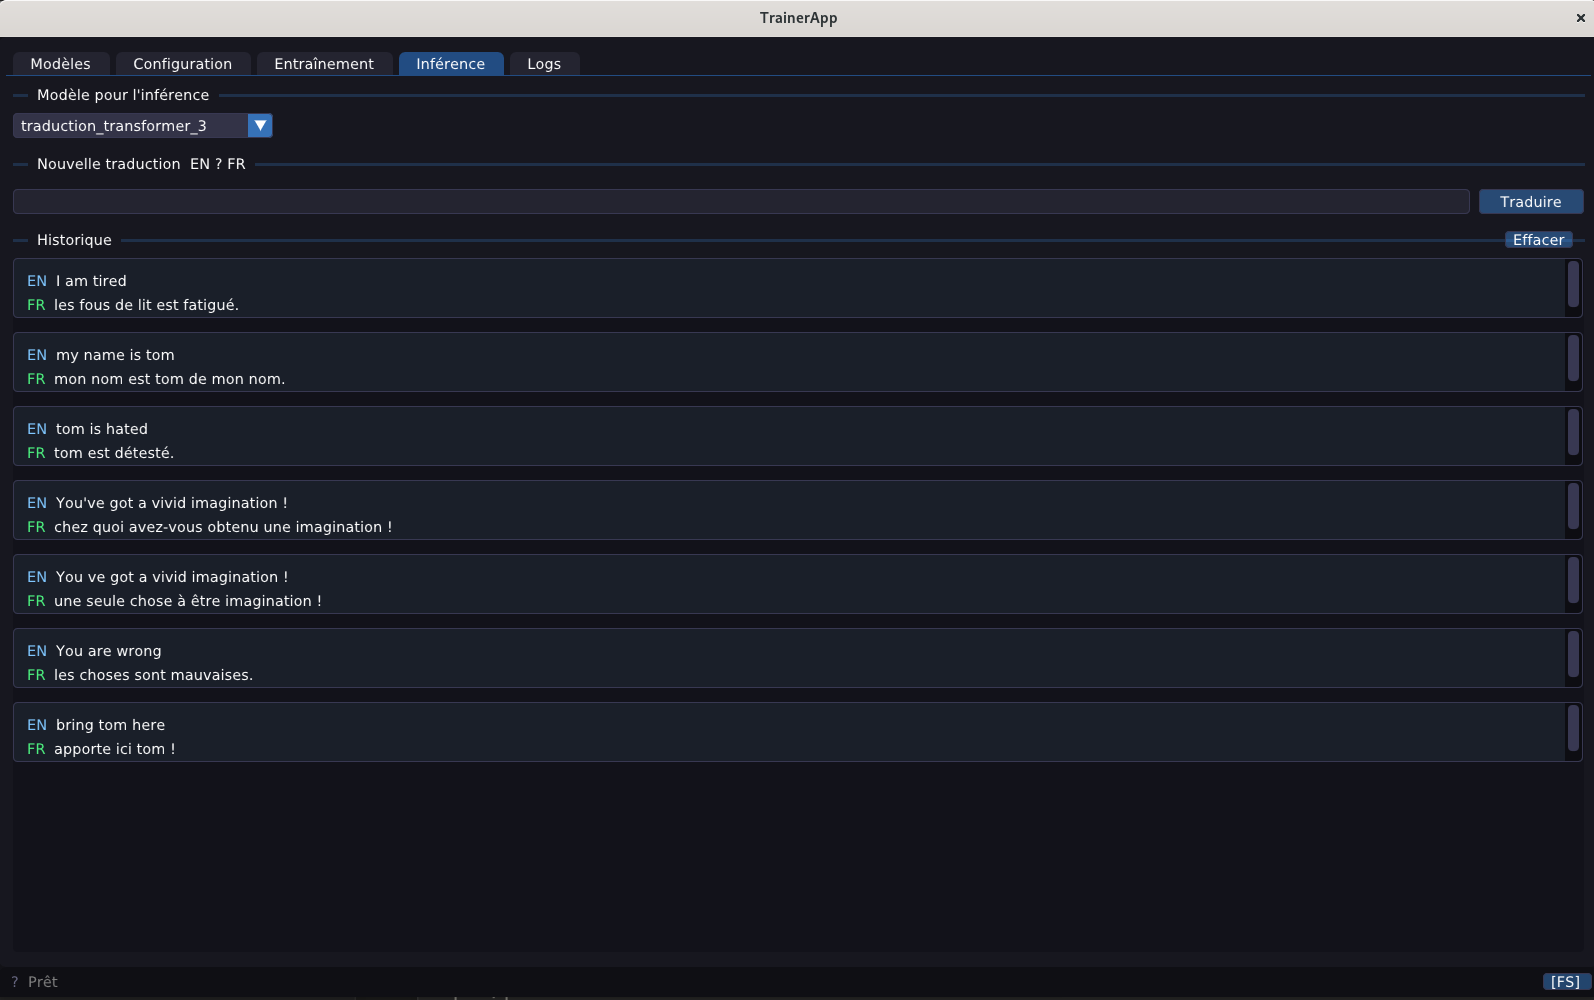
Pour piloter les entraînements et tester le modèle sans ligne de commande, une application compagnon (TrainerApp) a été développée par-dessus la bibliothèque : une interface graphique en C++17/ImGui avec des onglets Modèles, Configuration, Entraînement et Inférence. L'onglet Entraînement affiche en direct la perte train/validation, le score BLEU-4 et les traductions générées à chaque epoch, aux côtés de la mémoire et de l'utilisation GPU. Elle a depuis été étendue pour piloter également le CNN du projet ConvNetwork, devenant une petite plateforme d'entraînement multi-modèles.
TrainerApp — onglet Entraînement : perte train/val, score BLEU-4 (35 % à l'epoch 31) et traductions générées en direct.TrainerApp — onglet Inférence : traductions générées par le modèle et historique des requêtes.
TrainerApp pilote transformer_lib dans le même processus pour trois usages : entraînement (batches → passe graphée → Adam), évaluation (BLEU) et inférence (beam search). La bibliothèque s'appuie sur la VRAM (DevicePool, CUDA Graphs, cuBLAS) et sur des checkpoints disque, et renvoie les métriques qui alimentent les courbes de l'interface.
Points clés
Rétropropagation dérivée et codée à la main pour chaque couche, vérifiée par gradient checking
Backend CUDA device-resident (cuBLAS, kernels custom) validé couche par couche contre le CPU
Tokenizer BPE, pipeline de données et checkpointing binaire CPU/GPU écrits from scratch
Interface graphique compagnon (TrainerApp, ImGui) : suivi live de l'entraînement (perte, BLEU-4) et inférence interactive